- Details
- Geschrieben von: Moritz Conjé & Claude
- Kategorie: Homelab
- Zugriffe: 50
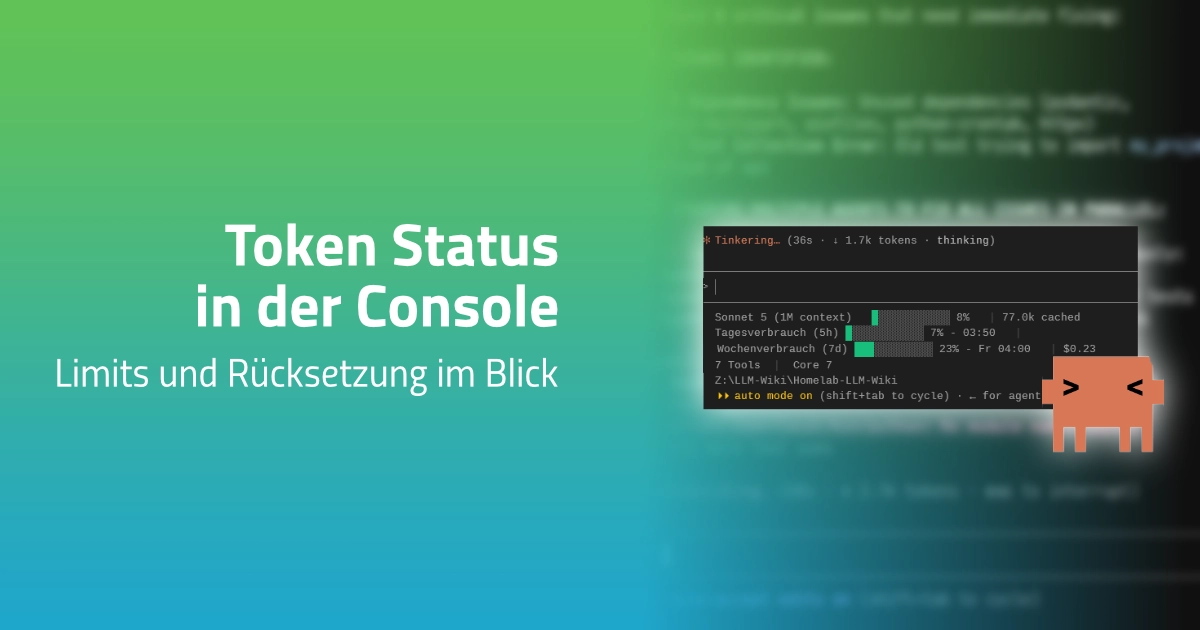
Wer täglich mit einer KI im Terminal arbeitet, kennt das Problem: Wie ausgelastet die laufende Sitzung gerade ist, wie nah man an ein Nutzungslimit kommt oder was sie bereits gekostet hat, bleibt normalerweise unsichtbar. Man merkt es meist erst, wenn ein Limit tatsächlich greift oder ein zu voller Kontext die Antwortqualität spürbar verschlechtert. Für die tägliche Arbeit mit Claude Code habe ich mir deshalb eine eigene, mehrzeilige Statuszeile gebaut, die diese Informationen laufend direkt im Terminal anzeigt.
Was im Hintergrund normalerweise unsichtbar bleibt
Eine KI-Sitzung im Terminal sammelt mit jeder Nachricht mehr Kontext an, verbraucht Anteile an Nutzungslimits und kostet Geld. All das läuft standardmäßig im Hintergrund ab. Ohne einen Blick darauf entsteht leicht ein blinder Fleck: Man merkt zu spät, dass der Kontext fast voll ist, dass ein Limit kurz vor dem Reset steht oder dass eine einzelne Sitzung ungewöhnlich viele Werkzeuge aufgerufen hat.
Die Lösung: eine eigene Statuszeile
Claude Code erlaubt es, die Statuszeile am unteren Bildschirmrand durch ein eigenes kleines Skript zu ersetzen. Es wird bei jeder Eingabe neu ausgeführt und bekommt aktuelle Kennzahlen zur laufenden Sitzung übergeben. Aus diesen Rohdaten baut das Skript eine kompakte, mehrzeilige Anzeige, die farbige Balken statt reiner Zahlenkolonnen nutzt: grün bei niedriger Auslastung, gelb ab etwa 70 Prozent, rot ab etwa 90 Prozent. So lässt sich der Zustand einer Sitzung auf einen Blick erfassen, ganz ohne die Zahlen im Detail lesen zu müssen.
Was die Zeile konkret zeigt
- Kontext-Auslastung: Wie viel vom verfügbaren Kontextfenster bereits belegt ist, samt Ampel-Farblogik.
- Nutzungslimits: Auslastung für die laufende Zeitspanne und die aktuelle Woche, jeweils mit Zeitpunkt der nächsten Zurücksetzung.
- Kosten: Die laufenden Kosten der aktuellen Sitzung in Echtzeit.
- Werkzeug-Nutzung: Wie viele Werkzeuge die KI in der Sitzung bereits aufgerufen hat und grob welcher Art.
- Arbeitskontext: Das aktuelle Arbeitsverzeichnis sowie, falls vorhanden, der aktive Git-Branch.
Fazit
Für sich genommen ist das ein kleines Werkzeug. In der täglichen Praxis macht es aber einen spürbaren Unterschied: Man verliert nie das Gefühl dafür, wie ausgelastet oder wie "teuer" eine Sitzung gerade ist, und bemerkt Auffälligkeiten sofort statt erst im Nachhinein. Ein gutes Beispiel dafür, dass die nützlichsten Verbesserungen im Umgang mit KI-Werkzeugen nicht immer neue Funktionen sind, sondern oft einfach bessere Sichtbarkeit auf das, was ohnehin schon passiert.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 86
Ein KI-Assistent kann schon ohne Erweiterungen erstaunlich viel. Für ein konkretes Projekt reicht „erstaunlich viel" aber selten als Arbeitsweise. Beim Aufbau des Second Brain kamen zuletzt drei sehr unterschiedliche, eigenständige Projekte zusammen: der Website-Relaunch, die Auswertung des Second Brain selbst und Architekturfragen im Homelab. Dieselbe allgemeine Unterhaltung dafür jedes Mal neu zu briefen, wäre möglich gewesen, aber ineffizient. Sinnvoller war es, gezielt nach Skills zu suchen: kleinen, wiederverwendbaren Fähigkeiten, die einen bestimmten Arbeitskontext mitbringen und sich automatisch je nach Aufgabe dazuschalten. Die schwierigste Frage dabei war nicht, ob es solche Erweiterungen gibt, sondern welche davon tatsächlich zum jeweiligen Problem passen und vertrauenswürdig genug sind.
Ein Skill ist kein Allzweck-Upgrade
Der Begriff klingt zunächst nach einem App-Store für die KI. Praktisch ist ein Skill eher eine konzentrierte Arbeitsanweisung samt Werkzeugen und Fachwissen für eine wiederkehrende Aufgabe – nicht dafür gedacht, den Assistenten grundsätzlich „besser" zu machen, sondern ein bestimmtes Problem verlässlicher abzudecken. Genau deshalb war die Zuordnung wichtiger als die Anzahl der Installationen: Ein Skill für Datenauswertung hilft nicht bei einer Architekturentscheidung, ein Paket für UI-Animation ist kein Ersatz für sauberes Systemdesign.
Drei laufende Projekte haben die eigentliche Auswahl strukturiert. Für den Website-Relaunch wurden Hilfen für Frontend-Gestaltung, Design-Kontext, UX-Referenzen und Animation gesucht. Das Second Brain brauchte Werkzeuge für Tabellen, Abfragen und Visualisierungen. Im Homelab ging es um Architektur, Fehlersuche, Dokumentation und Tests. Ergänzend, aber deutlich kleiner im Umfang, lief die laufende Blog-Redaktion mit – dafür reichte ein einzelner, unterstützender Skill gegen typische Textmuster im Deutschen, kein eigenes Paket.
Der Name allein reicht nicht
Die Recherche war der eigentliche Arbeitsaufwand. In Skill-Verzeichnissen tauchen oft ähnliche oder identische Namen auf, aber mit unterschiedlichen Autor:innen, Reifegraden und Zielen. Besonders deutlich wurde das bei einem bestimmten Stil-Korrektiv gegen zu generisch wirkende Designs: gleich vier verschiedene Repositories trugen praktisch denselben Namen. Erst der Blick in README, Verbreitung und Aktualität zeigte, welches davon das Original mit deutlichem Abstand war.
Auch exakte Bezeichnungen können täuschen. Ein gesuchter Daten-Skill hieß nicht create-wiz, sondern create-viz – ein einzelnes Zeichen Unterschied. Deutlich lehrreicher war ein zweiter Fehler: Zwei weitere Skills für Architektur und Fehlersuche schienen nach einer ersten, oberflächlichen Suche zu fehlen, waren im Quell-Repository bei genauerer Prüfung aber real vorhanden. Die Konsequenz: Bei Skill-Namen zählt nur die Prüfung direkt an der Quelle, nicht der erste schnelle Treffer.
Ein Blockversuch: echte Suche im Wiki
Ein Ziel ließ sich auf diesem Weg nicht erreichen. Parallel zur Skill-Suche wurde versucht, echte Volltextsuche über den gesamten Vault zu bekommen – nicht als neuer Skill, sondern über einen MCP-Server, der die Embeddings des bereits installierten Obsidian-Plugins Smart Connections wiederverwenden sollte. Der Versuch scheiterte an einer schlichten Versions-Inkompatibilität: Das Vault-Plugin läuft inzwischen auf Version 4.7, der verfügbare MCP-Server unterstützt bislang nur das ältere 3.x-Datenformat – Ergebnis war kein halb funktionierender Zugriff, sondern gar keine geladene Verbindung. Statt an dieser Stelle weiter zu debuggen, wurde der Ansatz bewusst zurückgestellt, die kaputte Server-Konfiguration wieder entfernt und eine unabhängige Alternative für einen späteren Anlauf vorgemerkt. Das daraus ein ganz eigenes Projekt werden würde (echtes Retrieval für den Second-Brain-Redakteur), ahnte ich zu diesem Zeitpunkt noch nicht.
Ergebnis: sieben Pakete für drei Projekte plus eine Randaufgabe
Am Ende standen sieben Plugins über die offizielle Claude-Code-Plugin-Verwaltung sowie ein eigenständiges Zehner-Skill-Paket, das über einen unabhängigen Installationsweg eingebunden wurde, weil es kein eigenes Marktplatz-Format mitbringt. Zugeordnet wurden sie so:
- Website-Relaunch: mehrere komplementäre Design-Skills – ein offizielles Frontend-Grundgerüst, ein Design-Kontext-Zwang vor dem eigentlichen Bauen, eine große UX-Referenzbibliothek, das erwähnte Stil-Korrektiv sowie das zehnteilige Paket für Mikrointeraktionen und Animation.
- Second-Brain-Auswertung: ein Analyse-Paket für strukturierte, tabellarische Daten – Dashboards, Statistik, Abfragen. Bewusst keine direkte Vault-Volltextsuche, dafür bleibt die oben beschriebene Lücke bestehen.
- Homelab-Architektur: ein Engineering-Paket mit Architekturentscheidungen, Code-Review, Fehlersuche und Deployment-Checklisten.
- Blog-Redaktion (unterstützend): ein einzelner Skill als Nachbearbeitungsschritt für Blog- und LinkedIn-Entwürfe, kein eigenständiges Projektpaket.
Alle Skills triggern seither automatisch je nach Aufgabenkontext, ohne einzeln aufgerufen werden zu müssen – geschrieben wird weiterhin ganz normal, das passende Fachwissen wird im Hintergrund dazugeschaltet.
Fazit und Ausblick
Der wichtigste Gewinn ist nicht die Zahl installierter Erweiterungen, sondern die Zuordnung: Drei laufende Projekte reagieren jetzt mit passenderem Kontext, ohne dass jede Aufgabe bei null anfängt, während die Blog-Redaktion bewusst nur eine kleine, unterstützende Ergänzung bekommen hat statt eines eigenen Pakets. Offen bleibt eine einzelne, aber spürbare Lücke: eine echte semantische Suche über den gesamten Second-Brain-Bestand, die am Versionskonflikt mit dem bestehenden Vault-Plugin gescheitert ist. Sie ist dokumentiert und wartet auf einen zweiten Anlauf. Fähigkeiten gezielt ergänzen, ihre Herkunft prüfen und eine Lücke lieber offen lassen als sie hinter einer scheinbaren Lösung zu verstecken – das bleibt für ein wachsendes Second Brain die brauchbarere Haltung. Der nächste Teil der Serie bleibt auf dieser Second-Brain-Ebene, wendet sich aber wieder einem konkreten Ergebnis statt einer offenen Baustelle zu.

- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 121
Der letzte Teil dieser Serie endete mit einer offenen Frage: Wie gut ein Redakteur Themen clustern kann, hängt direkt davon ab, was überhaupt an Input hereinkommt – und wie es dort ankommt. Der große Notion-Import hatte den bestehenden Wissensbestand ins Second Brain geholt, aber ein einmaliger Import ist kein Erfassungsweg für alles Zukünftige. Ein erster Blick auf die Zahlen war ernüchternd: Seit der Umstellung waren gerade einmal 3 von 1.630 Notizen über den neu eingerichteten Web-Clipper hereingekommen. Dazu kam ein zweites Problem im Bestand selbst – über 250 YouTube-Videos lagen nur mit Titel und Link vor, ohne durchsuchbaren Inhalt.
Web-Clipper: ein Template, das dem Import-Schema folgt
Damit neue Captures nicht an der bestehenden Struktur vorbeilaufen, folgt das Obsidian Web Clipper-Template exakt dem Property-Modell der bereits importierten Notizen: type und fileClass auf db_input-notizen, dazu Felder wie url, gespeichert_am und verschlagwortung. Der Web Clipper läuft aber als eigener Browser-Prozess, unabhängig von der offenen Obsidian-App – deshalb gibt es beim Clippen selbst keine Live-Vorschläge für Relations-Felder wie verschlagwortung, unabhängig davon, ob das Feld als Wikilink-Relation oder als natives Tag angelegt ist. Ein bereits aus dem Import bekannter Effekt also, nur an neuer Stelle. Die Verschlagwortung muss deshalb nach dem Clippen manuell im nativen Properties-Panel nachgetragen werden, dessen Autocomplete mit jedem im Vault verwendeten Wert mitwächst. Damit die geclippten Notizen anschließend nicht lose herumliegen, sortiert ein zusätzlich eingerichtetes Plugin (Advanced Note Mover) sie im 5-Minuten-Takt automatisch anhand ihres type-Werts in den richtigen Ordner ein.
Über 250 Videos ohne durchsuchbaren Inhalt
Das zweite Problem betraf nicht neue, sondern bereits vorhandene Notizen: YouTube-Videos, die zwar mit Link im Second Brain lagen, deren eigentlicher Inhalt aber nirgends durchsuchbar war. Die Lösung ist ein Python-Skript, das fehlende Transkripte über die YouTube-Transcript-API nachlädt und als eigenen Abschnitt an die bestehende Notiz anhängt, ohne Frontmatter, Links oder Verschlagwortung anzufassen. Wichtig für den praktischen Einsatz: Das Skript ist idempotent – bereits erledigte Notizen werden automatisch übersprungen, ein Lauf lässt sich beliebig oft neu starten und macht immer nur da weiter, wo der letzte aufgehört hat. Laufen muss es auf der Claude-Remote-LXC, weil nur die echten Internetzugang hat; die Cowork-Sandbox ist netzwerkseitig eingeschränkt.
Die erste, naive Skript-Version mit einer festen 1,5-Sekunden-Pause lief nach rund 30 erfolgreichen Abrufen in einen Block – YouTube stuft viele Anfragen in kurzer Zeit als Bot-Traffic ein, auch von ganz normalen Heim-IPs. Daraus wurde eine mehrstufige Anti-Block-Strategie: randomisierte Pausen zwischen 10 und 25 Minuten zwischen einzelnen Videos, zusätzlich alle 8 bis 15 Videos eine lange Verschnaufpause von 45 bis 90 Minuten, und bei erkanntem Block ein 45-Minuten-Backoff mit nur einem Retry – schlägt der fehl, wird das Video protokolliert und beim nächsten Lauf automatisch erneut versucht. Bewusst langsam, aber zuverlässig statt schnell und riskant.
Beim Nachfragen, wie groß das eigentliche Problem ist, zeigte sich: Der ursprüngliche Filter (YouTube-Link plus bestimmte Themen-Tags) erfasste nur 251 Notizen. Insgesamt lagen aber 703 YouTube-Links im Second Brain, davon 439 noch ganz ohne Transkript. Das Skript bekam deshalb ein zusätzliches Flag, das den Tag-Filter überspringt und alle betroffenen Notizen verarbeitet – 427 Videos, bei den vorsichtigen Pausen ein Lauf von rund vier bis acht Tagen am Stück - auf dem kleinen NUC aber kein Problem, der läuft eh 24/7.
Neue Video-Links werden über den Obsidian-Webclipper (Chrome-Extension) direkt mit Transcript erfasst und müssen kein zusäzliches Script durchlaufen.
Bücher als Wissensquelle: Ertel vs. Precht
Nicht jeder Erfassungsweg lässt sich automatisieren. Als Beispiel für die manuelle Verarbeitung habe ich zwei Bücher zum Thema KI gegenübergestellt: Wolfgang Ertels technisches Lehrbuch "Grundkurs Künstliche Intelligenz" und Richard David Prechts philosophischer Essay "Künstliche Intelligenz und der Sinn des Lebens". Beide behandeln KI aus komplett unterschiedlicher Richtung – der eine als Ingenieurshandwerk mit Formeln und Algorithmen, der andere als gesellschaftliche und ethische Frage –, ergänzen sich an mehreren Stellen aber mehr, als sie sich widersprechen: Ertels Kapitel zu neuronalen Netzen liefert etwa die technische Grundlage für Prechts Argument, warum KI kein "Selbst" entwickeln kann. Aus dem Vergleich ist eine eigene, strukturierte Notiz mit Kapitelübersicht zu beiden Büchern entstanden – ein Muster, das sich auf weitere Buchpaare übertragen lässt, statt jedes Buch isoliert zusammenzufassen. Das ersetzt nicht das selbstständige Lesen, ermöglicht aber einen schnellen Scan in Bezug auf konkrete Aspekte. Um die Bücher für die KI durchsuchbar zu machen, liegen sie komplett als *.md-Datei im Second Brain ab.
Ergebnis
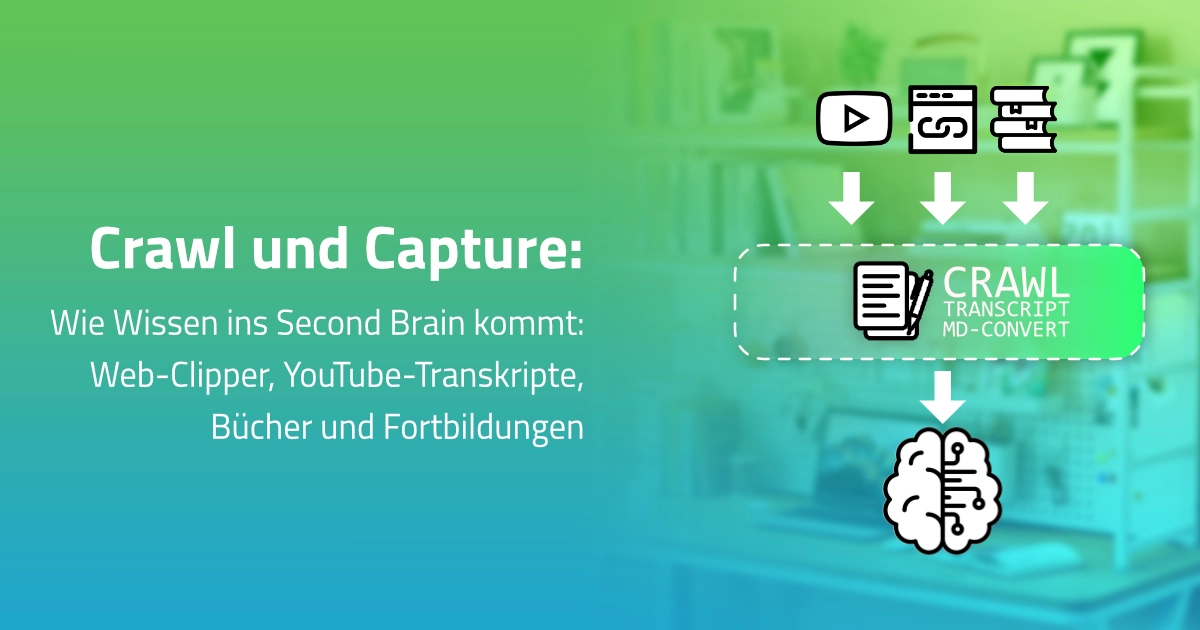
Die Erfassungspipeline funktioniert damit grundsätzlich auf drei Wegen: frisches Material über den Web-Clipper, nachträglich durchsuchbar gemachte Videos über das Transkript-Skript, und Bücher über eine manuelle, aber wiederholbare Vergleichsstruktur. Ganz fertig ist keiner der drei Wege: Die Web-Clipper-Einrichtung auf Handy und Rechner steht als Task noch aus, ebenso ein vollständiger Duplikat-Scan über den Bestand. Nebenbei korrigiert wurde außerdem ein Tippfehler in der Themenfelder-Liste ("Persönlichekitsentwicklung"), der beim Audit auffiel – über Obsidians eigene Umbenennungsfunktion, damit bestehende Verlinkungen dabei nicht brechen.
Ausblick
Damit kommt spürbar mehr Wissen ins Second Brain hinein als noch vor diesem Schritt. Ob es dort auch wiederfindbar ist, sobald es wirklich gebraucht wird, ist damit aber noch nicht beantwortet. Genau darum geht es im nächsten Teil dieser Serie: der Weg zur eigentlichen Wissenssuche.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 147
Das Rollenmodell aus den letzten Teilen dieser Serie beantwortet, wer im Second Brain mit welchen Rechten arbeitet. Offen blieb bislang eine ganz praktische Frage: Wo findet diese Arbeit eigentlich statt, wenn ich nicht am Schreibtisch-PC sitze? Das Second Brain lebt in einem Obsidian-Vault auf meinem Windows-Rechner – nützlich ist es aber nur, wenn ich auch von unterwegs damit arbeiten kann, mit echtem Zugriff auf den aktuellen Stand und nicht auf eine veraltete Kopie von gestern Abend.
Warum keine Kopie reicht
Die naheliegende Lösung wäre ein Sync-Mechanismus: Vault-Kopie auf ein zweites Gerät, Änderungen unterwegs, Abgleich beim nächsten WLAN-Kontakt. Für reines Lesen und gelegentliches Notieren würde das reichen. Für Arbeitssessions mit Claude Code aber nicht – hier sollen Änderungen sofort im echten Vault landen, ohne Merge-Konflikte zwischen zwei Ständen und ohne die Unsicherheit, ob die gerade sichtbare Version wirklich die aktuelle ist. Festgelegt habe ich mich deshalb nicht auf Sync, sondern auf einen Live-Mount: Ein separater Linux-Container greift über das Netzwerk direkt auf denselben Datenbestand zu, den auch Obsidian auf dem Windows-Rechner öffnet. Eine Änderung, egal von welcher Seite, ist sofort auf beiden Seiten sichtbar.
Die Basis: eine eigene LXC für Claude Remote
Technisch läuft das über eine eigene LXC (Proxmox-Container) namens claude-remote, unprivilegiert, Ubuntu 22.04, der im lokalen Netz erreichbar ist. Darauf läuft Claude Code über den nativen Installer. Der Zugriff läuft bei mir in der Praxis fast ausschließlich über die Android-App Termius: eigener SSH-Client mit hinterlegtem Key, damit lässt sich die LXC von unterwegs genauso ansteuern wie über ein Desktop-Terminal – die Claude-App mit ihrer eigenen Remote-Control-Funktion nutze ich mittlerweile kaum noch, SSH direkt reicht für den Alltag.
Der Netzwerk-Mount: Bind-Mount statt CIFS im Container
Der eigentliche Zugriff aufs Vault läuft über eine Windows-Freigabe auf dem TrueNAS-Server. Der naheliegende Weg, die Freigabe direkt im Container per CIFS zu mounten, funktioniert bei unprivilegierten LXCs allerdings nicht: Ihnen fehlen dafür die nötigen Kernel-Rechte. Der Ausweg liegt eine Ebene höher. Der Proxmox-Host selbst mountet die Freigabe (die Zugangsdaten liegen also nur dort, nicht im Container) und reicht anschließend gezielt nur die zwei tatsächlich benötigten Unterordner per Bind-Mount in den Container durch, nicht die gesamte NAS-Freigabe.
In der /etc/fstab des Hosts sieht das vereinfacht so aus:
//<nas-ip>/truenas-share/.../LLM-Wiki /mnt/llm-wiki cifs credentials=/root/.smbcredentials,_netdev,nofail 0 0Und die Durchreichung in den Container selbst:
pct set <container-id> -mp1 /mnt/llm-wiki,mp=/mnt/llm-wikiDamit sieht der Container ausschließlich /mnt/llm-wiki (und einen zweiten Ordner für sonstige Projekte), nicht den Rest der NAS-Freigabe. Ein Detail hat dabei unnötig Zeit gekostet: Der NAS-Unterpfad enthielt ein Leerzeichen im Ordnernamen, das in der fstab-Syntax als \040 escaped werden musste. Ohne diesen Handgriff bricht der Mount mit einer wenig hilfreichen „No such file or directory“-Meldung ab.
Erreichbarkeit von unterwegs: Tailscale statt Port-Forwarding
Im Heimnetz ist die LXC direkt per IP erreichbar. Für unterwegs braucht es mehr. Der bereits bestehende Reverse Proxy vor anderen Diensten im Homelab funktioniert hier nicht, weil er nur HTTP(S) auf Subdomains verteilt – SSH ist aber eine reine TCP-Verbindung, kein Web-Protokoll. Ich habe die LXC deshalb direkt ins bereits bestehende Tailscale-Netz aufgenommen, mit einer eigenen Adresse (clauderemote.tailXXXXXX.ts.net), erreichbar von jedem Gerät im selben Tailnet, unabhängig vom lokalen WLAN.
Ein Stolperstein dabei: Unprivilegierte Container haben standardmäßig kein /dev/net/tun-Gerät, das Tailscale zum Aufbau des virtuellen Netzwerk-Interfaces braucht. Die Freigabe muss – ähnlich wie beim NAS-Mount – vom Proxmox-Host aus erfolgen:
pct set <container-id> -dev0 /dev/net/tun,mode=0666
pct restart <container-id>
Danach lässt sich der Zugriff von einem beliebigen Gerät mit aktivem Tailscale-Client testen, in meinem Fall erfolgreich sowohl vom Laptop als auch vom Handy aus verifiziert – kein lokales WLAN und kein separates VPN mehr nötig, um an die Arbeit im Second Brain heranzukommen.
Projektstruktur: ein Ordner, ein Chat, gemeinsamer Kontext
Zwei Dinge lassen sich hier leicht verwechseln: der Chatverlauf und das Vault selbst. Claude Code speichert jede Session-Historie getrennt vom eigentlichen Arbeitsordner, verknüpft nur mit dessen exaktem Pfad – nicht im Vault, sondern in einem eigenen, internen Verzeichnis. Das Vault dagegen enthält ausschließlich die tatsächlichen Ergebnisse: Notizen, Aufgaben, Artikel-Entwürfe, Beschreibungen. Weil aber jede relevante Erkenntnis aus einer Session am Ende ohnehin als Dokumentation im Vault landet, lässt sich der Kontext auch ganz ohne den rohen Chatverlauf schnell wieder erfassen – die eigentliche Substanz steckt in den Dateien, nicht im Gesprächsprotokoll dahinter.
Zusätzlich lädt Claude Code beim Start automatisch jede CLAUDE.md-Datei von der Vault-Wurzel bis zum aktuellen Ordner. Für die Arbeit am Second Brain reicht es deshalb, direkt im Wurzelverzeichnis des Vaults zu starten – der gesamte gemeinsame Kontext (Regeln, Infrastrukturwissen, bisherige Entscheidungen) wird dabei automatisch geladen, ohne einen zusätzlichen Schritt:
cd /mnt/llm-wiki/Homelab-LLM-Wiki
claude
Eine Beispielsession
Konkret sieht ein typischer Arbeitseinstieg von unterwegs so aus: Tailscale-App auf dem Handy ist aktiv und im richtigen Tailnet angemeldet. Per SSH-Client (bei mir Termius) geht es auf claude-remote.tailXXXXXX.ts.net. Geht es um ein bereits laufendes Thema, hole ich mir per claude --resume "<Projektname>" genau diese Session zurück – unabhängig davon, wie lange die letzte Verbindung her ist. Für ein neues Thema wechsle ich stattdessen einfach in den gemounteten Vault-Ordner und starte frisch. Von dort aus läuft alles wie am Schreibtisch: Notizen lesen, Artikel-Entwürfe schreiben, Aufgaben im Second Brain anlegen oder verschieben. Jede Änderung landet direkt auf dem TrueNAS-Share – öffne ich anschließend Obsidian auf dem Windows-Rechner, ist sie dort ohne einen weiteren Schritt sichtbar, weil beide Seiten denselben Netzwerk-Speicher lesen, nicht zwei unabhängige Kopien.
Absicherung: Backup auf einen externen Server
Der Live-Mount hat eine Kehrseite: Es gibt keinen zweiten, leicht verzögerten Stand mehr, der einen fehlerhaften Schreibvorgang abfedert – jede Änderung landet sofort im einzigen echten Datenbestand. Deshalb läuft parallel ein täglicher TrueNAS-Cloud-Sync-Task, der das komplette Vault per WebDAV auf einen externen Server pusht – einen Nextcloud-Webspace außerhalb des eigenen Netzwerks, unabhängig von einem Ausfall der eigenen Hardware. Dieser Live-Abgleich läuft bereits produktiv; eine Erweiterung um ein echtes versioniertes Backup mit mehrwöchiger Datums-Historie ist angelegt, aber noch nicht zuverlässig im produktiven Einsatz.
Ergebnis
Der Zugriff aufs Second Brain ist damit nicht mehr an einen bestimmten Rechner gebunden. Getestet und bestätigt von zwei unterschiedlichen Endgeräten – Laptop und Handy –, jeweils mit demselben Ablauf: Tailscale verbinden, per SSH auf die LXC, direkt am echten Vault arbeiten. Kein Sync-Skript, kein Merge, keine Frage, welche Version gerade die aktuelle ist.
Ausblick
Für den nächsten Teil dieser Serie geht es wieder zurück auf die inhaltliche Ebene: wie über Web-Clipper, YouTube-Transkripte und Bücher überhaupt neues Wissen ins Second Brain hineinkommt.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 219
Der Second-Brain-Bibliothekar aus Beitrag 4 darf laut Rollenmodell keine Quellnotizen verändern – nur lesen. Das wirft sofort eine praktische Frage auf: Wie kommen seine Erkenntnisse dann überhaupt irgendwo an? Und wie bleibt nachvollziehbar, wenn derselbe Themencluster über mehrere Läufe hinweg immer wieder auftaucht? Bis zur Antwort brauchte es mehrere Entwurfsrunden – und am Ende einen ersten echten Testlauf über 100 Notizen.
Das Problem: Erkenntnisse ohne Schreibrecht
Ohne Schreibrecht auf die Quellen bleibt dem Bibliothekar nur ein Weg: ein eigenes, separates Ergebnisdokument. Aber ein einzelnes Dokument pro Lauf reicht nicht, wenn Cluster nicht sauber voneinander abgegrenzt sind oder derselbe thematische Zusammenhang bei jedem neuen Lauf wie ein völlig neuer Fund erscheint, obwohl er eigentlich zu einem bereits bekannten Thema gehört.
Ein Schema, das mehrere Runden brauchte
Das Übergabe-Artefakt-Schema ist deshalb nicht am Reißbrett entstanden, sondern iterativ auf einem Canvas gewachsen, in mehreren geprüften und verfeinerten Runden. Zentrale Bausteine am Ende: eine kategorie ("Neues Potenzial" vs. "Ergänzung/Synergie"), ein Reifegrad (Inbox → Seed → Growing → Evergreen) sowie eine Cluster-ID. Die Cluster-ID war dabei die wichtigste Designentscheidung: Sie ist bewusst persistent, wächst über mehrere Läufe hinweg statt bei jedem Lauf neu zu beginnen. Der Gedanke dahinter: Es geht nicht nur darum, Muster vorzugeben, sondern ihnen auch zu erlauben, sich über Zeit weiterzuentwickeln. Aus dem Canvas-Entwurf wurde anschließend eine echte Vorlage plus eigene Datenbank im Vault.
Technische Grenzen unterwegs
Nicht alles ließ sich wie geplant umsetzen. Die Cluster-ID hat keine live nachschlagbare Referenz – aus einer Datenbank-Formel heraus lässt sich in Obsidian derzeit keine Property einer verlinkten Notiz auslesen, bestätigt gegen die offizielle Dokumentation. Auch die Routing-Regel, die festlegt, welche Kategorie an mich direkt geht und welche an den Agenten Cowork, ist bislang nur vorläufig – "erstmal so, und dann sehen, wie das im Alltag funktioniert", mit einem noch terminlosen Review nach etwas praktischer Erprobung. Und wer über die Basis-Einstufung hinaus einen höheren Reifegrad vergeben darf – ich selbst beim Sichten, oder der Second-Brain-Bibliothekar heuristisch beim Verarbeiten –, war mangels ausreichender Praxisdaten schlicht noch nicht zu entscheiden.
Drei echte Testläufe
Trotz dieser offenen Punkte bin ich nicht beim Entwerfen stehen geblieben, sondern habe das Schema dreimal an echten Daten getestet: einmal als Audit der bestehenden Themenfelder-Liste, einmal als Abgleich eines einzelnen Inputs gegen bereits vorhandene eigene Ausarbeitungen, und schließlich als eigentlicher Belastungstest – ein Batch-Lauf über 100 Input-Notizen. Ergebnis dieses dritten Laufs: sieben Übergabe-Artefakte, von einem 32 Quellen starken Cluster zu Obsidian-Tooling bis zu einem einzelnen, aber wertvollen Duplikat-Hinweis. Parallel dazu habe ich die Reifegrad-Baseline "Inbox" rückwirkend auf den gesamten Bestand angewendet – 1.662 von 1.665 Input-Notizen, bewusst ohne Sonderbehandlung der Notizen, die durch den Testlauf bereits mit einem Cluster verknüpft waren.
Ergebnis
Das Rollenmodell aus Beitrag 4 hat sich damit erstmals nicht nur auf dem Papier, sondern an echten Daten bewährt. Ganz abgeschlossen ist das Thema damit aber nicht: Offen bleiben unter anderem eine echte Liste noch unausgereifter Cluster über mehrere Läufe hinweg, die Überprüfung der Routing-Regel nach etwas mehr Praxis, die eigentliche Hochstufungslogik über die Baseline hinaus, ein vollständiger Duplikat-Scan über den gesamten Bestand sowie ein Log, das echte Übergaben zwischen den Rollen nachvollziehbar macht.
Ausblick
Der Testlauf hat vor allem eines gezeigt: Wie gut der Bibliothekar clustern kann, hängt direkt davon ab, was überhaupt an Input hereinkommt – und wie es dort ankommt. Genau darum geht es im nächsten Teil dieser Serie: die verschiedenen Wege, auf denen neues Wissen mein Second Brain überhaupt erreicht.
- Die fünfte Rolle: wie der Kurator (agt_kur) das Rollenmodell selbst korrigiert
- Vier Rollen für ein Second Brain: wie ich Agenten-Verantwortlichkeiten definiert habe
- Wenn das Kanban-Board bricht: Grenzen des Task-Board-Plugins und der Weg zu Bases
- Vom PARA-Schema zum Prozessmodell: wie mein Second-Brain-Konzept gereift ist