
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 216
Ein Rollenmodell zu entwerfen und mit genau diesem Entwurf gegen eine bereits getroffene, dokumentierte Entscheidung zu verstoßen, ohne es zu merken – das ist mir beim Ausarbeiten meiner fünften Rolle tatsächlich passiert. Aufgefallen ist der Widerspruch nicht automatisch, sondern erst beim genauen Nachlesen. Genau diese Lücke schließt die Rolle, die aus diesem Vorfall entstanden ist.
Ein Widerspruch, den ich selbst übersehen hatte
Mein Agent Cowork, die vierte Rolle aus dem vorherigen Beitrag dieser Serie, stellt Dokumentationskonsistenz im laufenden Sessionfluss nicht zuverlässig selbst her: Eine Entscheidung wird getroffen und in ein Dokument geschrieben, verwandte Dokumente werden dabei aber nicht immer mitgezogen. Sichtbar wurde genau das ausgerechnet am eigenen Rollenentwurf. Die Idee zu einer neuen, fünften Rolle – dem Kurator selbst – widersprach beim Entwerfen zunächst unbemerkt einer bereits getroffenen Entscheidung: keine eigene Wiki-Ebene-Rolle. Aufgedeckt hat das erst der explizite Abgleich beim Review, nicht ein automatischer Mechanismus.
Kein fünfter gleichrangiger Schritt, sondern ein Unter-Agent
Statt den Kurator als fünften, zu den anderen vier gleichrangigen Prozessschritt einzuordnen, habe ich ihn bewusst als Sub-Agent zum Agent Cowork angelegt. Er setzt ausschließlich im Anschluss an eine abgeschlossene Agent-Cowork-Session an – nicht parallel dazu und nicht an ihrer Stelle. Den Session-Diff, also die Frage, was in der letzten Sitzung überhaupt verändert wurde, löse ich dabei bewusst nicht über neue Infrastruktur, sondern über eine bereits bestehende Spalte in meinem Session-Log: Die dort ohnehin vermerkten, betroffenen Dokumente bilden den Ausgangspunkt der Prüfung.
Drei Stufen statt sofortiger Automatisierung
Die Bauweise habe ich bewusst in drei Stufen geplant, jede folgende erst nach Bewährung der vorherigen:
- Aktueller Stand: eine explizite Ja/Nein-Abfrage am Sessionende – der Agent Cowork fragt aktiv nach, ob der Kurator jetzt starten soll.
- Später: automatische Nachbereitung ohne einzelne Abfrage, sobald sich der Ablauf im Alltag bewährt hat.
- Optional, ausdrücklich ungeklärt: eine mögliche spätere Integration in mein System für unbeaufsichtigten Betrieb – bewusst kein Vorgriff, nur als Gedanke vorgemerkt.
Wo es beim Entwerfen klemmte
Zwei Punkte ließen sich nicht ohne Reibung klären. Der Kurator grenzt sich bewusst eng von der bereits bestehenden, breiteren Wiki-Pflege-Aufgabe des Agent Cowork ab – dessen periodischer Scan über beliebige Wiki-Bereiche bleibt unverändert dort verortet, um keine Doppelrolle entstehen zu lassen. Zusätzlich zeigte sich, dass eine erst kurz zuvor verschärfte Log-Regel (Abfrage vor jedem Eintrag) eine erneute, mehrtägige Lücke in der Protokollierung nicht verhindert hatte. Die Konsequenz: Der Log-Eintrag ist jetzt nicht mehr abfragebasiert, sondern folgt automatisch auf jede Session – ohne diese Verschärfung hätte dem Kurator strukturell die eigene Arbeitsgrundlage gefehlt.
Der erste Testlauf noch am selben Tag
Der Scope blieb bewusst eng: geprüft wird nur die zuletzt abgeschlossene Session, nicht das gesamte Wiki. Beim Korrekturprinzip habe ich dieselbe Regel wie beim Agent-Cowork übernommen – Direktänderung ist der Normalfall, bei einem echten Quellwiderspruch markiert der Kurator stattdessen einen offenen Konflikt, statt eigenmächtig zu überschreiben. Noch am selben Tag kam es zum ersten echten Lauf, manuell von mir gestartet: Der Kurator prüfte den Session-Diff aus dem letzten Lauf des Agent Redakteur und fand sechs kaputte Wikilinks in den Übergabe-Artefakten – verlinkt waren Projektordner-Namen statt der tatsächlichen Notiz-Titel – sowie zwei veraltete Cross-Referenzen. Alle Funde wurden direkt korrigiert. Einen weiteren Fund außerhalb des eigentlichen Session-Scopes, einen leeren Projektordner, hat der Kurator bewusst nur vermerkt und nicht eigenständig korrigiert.
Ergebnis
Aus dem Vier-Rollen-Modell ist damit ein Fünf-Rollen-Modell geworden, mein zentrales Übersichtsdokument zur Zusammenarbeit der Agenten entsprechend ergänzt. Bemerkenswert war dabei weniger die Technik als der Auslöser selbst: Die Rolle, die künftig genau solche Inkonsistenzen aufdecken soll, ist aus einer Inkonsistenz an ihrem eigenen Entwurf entstanden.
Ausblick
Ob sich der Kurator im Alltag tatsächlich bewährt und wann die zweite Ausbaustufe – die automatische Nachbereitung ohne Abfrage – folgt, wird sich erst über mehrere echte Sessions zeigen. Wie sich das erweiterte Rollenmodell insgesamt in der Praxis schlägt, davon handelt einer der nächsten Beiträge dieser Serie.

- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 240
Irgendwann habe ich nachgezählt: 1.638 Input-Notizen standen nur 36 tatsächlich verarbeiteten Notizen gegenüber – weniger als drei Prozent. Das Sammeln hatte in meinem Second Brain längst funktioniert, das Verarbeiten nicht. Die eigentliche Frage war dabei gar nicht technischer Natur: Wer oder was sollte diesen Rückstau abarbeiten, und mit welchen Rechten sollte dabei gearbeitet werden dürfen?
Ein Rückstau, der eine Struktur brauchte
Eine einzelne, allzuständige KI-Rolle für alles – Sichten, Entscheiden, Schreiben, Veröffentlichen – schien mir keine gute Idee. Zu viel Verantwortung an einer Stelle, zu wenig Möglichkeit, im Alltag noch nachzuvollziehen, was gerade automatisch passiert und was nicht. Also stand am Anfang keine technische Frage, sondern eine organisatorische: Welche Teilaufgaben lassen sich sauber trennen, und welche Rechte braucht jede dieser Teilaufgaben tatsächlich – nicht mehr, aber auch nicht weniger?
Vier Rollen statt einer allzuständigen KI
Entstanden ist ein Vier-Rollen-Modell, jede mit klar unterschiedlichem Zugriff:
- Agent Second-Brain-Bibliothekar [agt_bib] – arbeitet auf der Input-Ebene, sichtet und clustert die rohen Notizen. Nur Leserechte auf die Quellen; einziger erlaubter Schreib-Output ist ein eigenes Übergabe-Artefakt mit Vorschlägen, keine direkte Veränderung an den Notizen selbst.
- Agent Cowork [agt_cw] – der eigentliche Default-Modus meiner interaktiven Arbeit mit Claude: Tasks bearbeiten, Dokumentation pflegen, neue Aufgaben definieren. Hier gibt es echtes Schreibrecht, weil ich im selben Arbeitsschritt mitentscheide – anders als bei den unbeaufsichtigt laufenden Rollen. Der Prozess-Agent challenged die Übergabe-Artefakte und erzeugt nach Absprache daraus Aufgaben oder detaillierte, umfangreichere Notizen.
- Agent Redakteur [agt_red] – übernimmt die Content-Erstellung von Aufgaben im Bereich Blogbeitrags, aber ohne Themenhoheit, erst nach Übergabe: Welches Thema überhaupt zum Blogbeitrag wird, entscheidet nicht diese Rolle. Schreibrecht nur im Entwurfsordner, kein Publish-Recht.
- Agent Live-Coach [agt_lc] – bisher nur perspektivisch gedacht, für Quartals- und Jahresreviews im direkten Dialog statt ereignisgetriggert wie die anderen drei Rollen.
Wo es zu klemmen begann
Zwei Punkte ließen sich nicht am Reißbrett klären. Der Agent Cowork blieb zunächst ein reiner Platzhalter – die eigentliche Frage war, ob das überhaupt eine eigene Rolle mit eigenem Profil ist, oder einfach die Bezeichnung für meine ganz normale, bereits gelebte Zusammenarbeit mit Claude. Und beim Agent Redakteur stand die Frage im Raum, ob ein erfülltes Abnahmekriterium (eigener Skill, erfolgreicher Testlauf) automatisch zur Freigabe führen sollte, oder ob es dafür immer noch eine explizite Entscheidung von mir braucht.
Vom Prinzip zur Regel
Beide Fragen und einige weitere haben sich erst über 17 Protokoll-Runden in zwei separaten Sitzungen wirklich geschärft – nicht an einem Nachmittag entschieden, sondern schrittweise durchdacht. Am Ende standen konkrete, eindeutig anwendbare Regeln statt vager Prinzipien:
- Der Agent Cowork bearbeitet Dateien standardmäßig direkt, mit genau einer Ausnahme: Datei-Umbenennungen bleiben bei mir. Grund ist rein technisch – nur Obsidians eigener Umbenennen-Befehl aktualisiert Wikilinks vault-weit zuverlässig, ein externes Skript würde tote Links hinterlassen.
- Beim Agent Redakteur gibt es keine automatische Freigabe, selbst wenn alle Abnahmekriterien formal erfüllt sind. Es braucht immer eine konkrete, positiv zu beantwortende Freigabefrage an mich – eine bewusste Erweiterung des Grundprinzips "Automatisierung schlägt vor, ich entscheide": auch bei erfüllten Kriterien keine stille Statusänderung.
Ergebnis
Alle vier Rollen sind inzwischen als Entwürfe dokumentiert. Drei davon habe ich bereits in der Praxis getestet, mit durchaus unterschiedlichen Ergebnissen – davon handelt der nächste Teil dieser Serie.
Ausblick
Ein Rollenmodell auf dem Papier ist die eine Sache, ein echter Testlauf mit echten Daten eine andere. Wie der Agent Second-Brain-Bibliothekar zum ersten Mal auf 100 echte Input-Notizen losgelassen wurde und was dabei tatsächlich herauskam, zeigt der nächste Beitrag.
- Häufige Fragen:
- Frage: Warum nutzt ein Second Brain mehrere KI-Rollen statt einer einzigen?, Antwort: Eine allzuständige KI, die sichtet, entscheidet, schreibt und veröffentlicht, konzentriert zu viel Verantwortung an einer Stelle. Im Alltag lässt sich dann kaum nachvollziehen, was automatisch passiert. Deshalb sind die Teilaufgaben getrennt, und jede Rolle bekommt nur die Rechte, die sie tatsächlich braucht.
- Frage: Welche vier Rollen gibt es im Second Brain, und was darf jede?, Antwort: Der Bibliothekar sichtet und clustert Notizen und darf nur lesen. Der Prozess-Agent (Cowork) ist der Standardmodus der interaktiven Arbeit und darf schreiben, weil der Autor im selben Schritt mitentscheidet. Der Redakteur schreibt Blogentwürfe, aber nur in den Entwurfsordner und ohne Recht zum Veröffentlichen. Der Live-Coach ist für Quartals- und Jahresreviews vorgesehen.
- Frage: Warum darf keine der Rollen automatisch etwas freigeben?, Antwort: Auch wenn alle Abnahmekriterien formal erfüllt sind, braucht es immer eine ausdrückliche Freigabe des Autors. Das Prinzip lautet: Die Automatisierung schlägt vor, der Autor entscheidet. Stille Statusänderungen soll es nicht geben.
- Frage: Warum wurde ein Vier-Rollen-Modell überhaupt aufgebaut?, Antwort: Im Second Brain standen 1.638 Inputerarbeiteten gegenüber, weniger als dreiProzent. Das Sammeln funktionierte, das Verarbeiten nicht. Die Rollen sollen diesen Rückstau strukturiert abarbeiten.

- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 243
Mit dem Prozessmodell stand fest, wie ich über mein Second Brain denken will. Für die tägliche Arbeit brauchte ich aber auch ein Werkzeug, das dieses Denken abbildet – ein Kanban-Board für Projekte und Aufgaben. Genau dort brach mir wenig später eines meiner vier bestehenden Boards weg, ohne jede Fehlermeldung. Der Grund dafür lag tiefer, als ich zunächst vermutet hatte.
Der eigentliche Fehler: Ordnerpfad statt Property
Das bisher genutzte Plugin Task Board filtert seine Boards ausschließlich über einen exakten Ordnerpfad-Präfix. Jede Umbenennung oder Verschiebung eines Ordners bricht diesen Filter lautlos – keine Fehlermeldung, das Board zeigt einfach null oder falsche Karten an. Genau das war bei einem meiner vier Boards bereits real passiert: Der hinterlegte Pfad existierte nicht mehr, obwohl die zugehörigen Karten mit korrektem Tag weiterhin im Vault lagen.
Bestandsaufnahme vor der Entscheidung
Bevor ich etwas geändert habe, habe ich den tatsächlichen Bestand geprüft: 76 offene und 7 erledigte Karten, verteilt auf vier Boards. Dabei kamen zwei weitere, unabhängige Probleme ans Licht. Erstens: Welcher Spalte eine Karte zugeordnet wird, hing tatsächlich an einem Tag, nicht am eigentlich dafür vorgesehenen Status-Feld – Letzteres war teils veraltet und stimmte nicht mehr zuverlässig mit der echten Spalte überein. Zweitens: Zwei Boards teilten sich denselben Ordner und denselben Tag für ihre Follow-up-Spalte, wodurch identische Karten in beiden Boards auftauchten. Der naheliegende Versuch, das durch Verschieben einzelner Dateien zwischen den Ordnern zu entwirren, erwies sich als Sackgasse – die Karten gehörten inhaltlich zu Recht in beide Kontexte, das Problem lag an der reinen Tag-Logik, nicht an der Dateiablage.
Werkzeugwahl: Bases statt Task Board
Obsidian Bases, das Core-Plugin für property-gefilterte Ansichten, war bei mir bereits im Second-Brain-Bereich im Einsatz – kein neues Konzept, sondern ein bewährtes Muster, das sich auf die Boards übertragen ließ. Ein Community-Plugin namens "Project Manager" habe ich bewusst verworfen: Es hätte ein drittes, konkurrierendes Datenmodell neben Bases und dem bestehenden Second-Brain-Schema eingeführt und selbst wieder mit derselben Ordner-first-Logik gearbeitet, die ich gerade ablösen wollte. Für die eigentliche Kanban-Optik habe ich zunächst das Community-Plugin "Base Board" installiert – Spalten werden direkt aus einer beliebigen Frontmatter-Property erzeugt, Drag & Drop schreibt die Property unmittelbar in die Datei zurück, kein eigener Pfad-Cache mehr. Weil es aber keine Swimlanes unterstützt, bin ich stattdessen auf Bases Kanban (Community-Plugin kanban-bases-view) umgestiegen, das dieselbe property-basierte Logik mitbringt und zusätzlich eine zweite Gruppierungsebene erlaubt.
Migration in der Praxis: ein paar Stolpersteine
Die eigentliche Umstellung – Tags/Status per Skript auf ein neues type/status-Schema (`prt_
Ergebnis
Alle vier ursprünglichen Boards sind migriert, dabei wurden es wegen der aufgedeckten Überschneidung bewusst fünf eigenständige Ansichten statt vier. Sämtliche 68 migrierten Original-Karten liegen jetzt archiviert, das alte Task-Board-Plugin ist deaktiviert. Sogar der Migrationsplan selbst ist inzwischen als eigene Karte im neuen System eingetragen – ein passender Schlusspunkt für ein Projekt, das mit einer lautlos verschwundenen Karte begann.
Ausblick
Offen bleibt vor allem die Dokumentation: Die Beschreibung des alten Board-Schemas muss noch durch das neue ersetzt werden, ebenso die Frage, ob die bisherige Ordnerstruktur als reine Ablage-Konvenienz erhalten bleibt. Wie es sich anfühlt, mit diesem neuen, property-basierten System tatsächlich zu arbeiten – etwa bei der Frage, wer im Second Brain und KI-Agenten welche Karten anlegen und bearbeiten darf –, ist Thema eines der nächsten Beiträge dieser Serie.

- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 223
Nach dem Datenimport aus Notion stand die nächste Frage im Raum: Nach welcher Logik sollen die zusammengeführten Daten künftig geordnet werden? Naheliegend war PARA (Projects/Areas/Resources/Archive) / fortelabs.com – das bekannteste Ordnungssystem in diesem Umfeld. Es fühlte sich aber von Anfang an nicht richtig an, ohne dass ich genau hätte benennen können, warum - (siehe Beitrag 1 dieser Serie).
PARA prüfen, PARA verwerfen
Ein strukturierter Abgleich anhand mehrerer Leitfragen brachte die eigentliche Ursache ans Licht: Ich denke prozessorientiert ("was ist als Nächstes zu tun"), nicht ablageorientiert ("wo liegt das ab"). Die vier festen PARA-Kategorien wirkten für meine tatsächlichen Themen zu starr. Vor allem aber ist PARA eine reine Ablage-Taxonomie – Dashboard, wiederkehrende Reviews und Claude als aktiver Mitwirkender kommen darin schlicht nicht vor, obwohl genau das für mein System zentral sein sollte.
Referenzmodelle im Vergleich
Bevor ich PARA verworfen habe, habe ich mehrere Modelle nicht gegeneinander, sondern übereinander gelegt – als unabhängige Achsen auf denselben Inhalt, nicht als konkurrierende Alternativen:
- Workflow-Achse (C.O.D.E.): Capture → Organize → Distill → Express – beantwortet, was gerade mit einem Inhalt passiert.
- Ablage-Achse (lose PARA-Begriffe): beantwortet, wo ein Inhalt aktuell einsortiert ist.
- Reifegrad-Achse: Inbox → Seed → Growing → Evergreen – beantwortet, wie weit ein Inhalt inhaltlich verdichtet ist.
Die wichtigste Erkenntnis dabei: Ablageort und Reifegrad sind unabhängig voneinander. Eine Notiz kann bei den Resources liegen und trotzdem noch im Reifegrad Seed sein – der Ordner sagt nichts über die inhaltliche Qualität aus. Parallel dazu habe ich einen ersten System-Prompt entworfen, der Claude als Co-Piloten für dieses Second Brain positioniert – ein erster Versuch, das Konzept in eine Form zu bringen, mit der sich tatsächlich arbeiten lässt.
Klärungsbedarf unterwegs
Ein paar Punkte mussten sich im Verlauf noch präzisieren. Der wichtigste: "Archiv" sollte kein physischer Ordner sein, in den Inhalte verschwinden, sondern ein Property-Filter – der Inhalt bleibt an seinem Ort, nur sein Status ändert sich. Zwei weitere Fragen blieben zunächst offen: welches Werkzeug sich fürs Erfassen neuer Inhalte unterwegs eignet, und wie sicher automatisierte Abläufe (Cronjobs, die im Hintergrund Reviews anstoßen) laufen dürfen, ohne dass etwas unbeaufsichtigt passiert.
Die Entscheidung: ein eigenes Prozessmodell
Am Ende stand eine bewusste Richtungsentscheidung: PARA verworfen zugunsten eines eigenen Prozessmodells – Input → Review-Vorschlag → Task/Project → Extrakt → Dashboard, mit einem Cronjob und Claude als aktiven Akteuren im Review-Schritt. Entscheidend dabei: Dieser Review-Schritt erzeugt ausdrücklich nur Vorschläge, keine automatisch übernommenen Aufgaben. Erst wenn ich mich aktiv einem Vorschlag zuwende, wird daraus etwas Verbindliches. Auch die Automatisierung selbst bleibt vorerst zurückhaltend: Der Cronjob startet nur auf Anweisung, volle Automatisierung folgt frühestens, "wenn sich der Prozess bewährt hat" – eine bewusste Sicherheitsgrenze, keine technische Verlegenheitslösung.
Ergebnis
Aus diesem Abgleich ist ein konsolidiertes Zielverständnis-Dokument entstanden, das seit heute als gemeinsame Referenz für alle weiteren Arbeiten am Second Brain dient – für mich selbst ebenso wie als Grundlage, gegen die sich Claude in künftigen Sessions abgleichen lässt.
Ausblick
Mit einem Prozessmodell statt einer Ablage-Taxonomie stand fest, wie ich künftig über mein Second Brain denken will. Wie sich das auf der Werkzeugebene tatsächlich umsetzen lässt, erwies sich schnell als eigene Baustelle – etwa bei der Suche nach einem Projekt-Board, das zu diesem Prozessdenken passt, statt es zu untergraben. Davon handelt der nächste Teil dieser Serie - Wenn das Kanban-Board bricht: Grenzen des Task-Board-Plugins und der Weg zu Bases.
- Details
- Geschrieben von: Moritz Conjé & Claude (Co-Autor)
- Kategorie: Homelab
- Zugriffe: 223
Bevor ich mich der eigentlichen Ordnungsfrage meines Second Brain zugewandt habe (Vom PARA-Schema zum Prozessmodell: wie mein Second-Brain-Konzept gereift ist), musste ich mir über etwas Grundlegenderes klar werden: Wie hält man Kontext über viele Chat-Sessions mit Claude hinweg eigentlich zusammen? Ein einzelner Chat lässt sich zwar über verschiedene *.md-Dateien – unter anderem eine MEMORY.md – recht gut mit Kontext ausstatten. Trotzdem bleibt er im Kern ein einzelnes, unabhängiges Gespräch. Bei nur einem Projekt fällt das kaum auf. Bei mehreren, teils eng verzahnten Projekten wird daraus schnell ein Problem.
Vom Einzel-Chat zum Multi-Projekt-Kontext
Der nächste naheliegende Schritt ist die Bündelung: mehrere Chats innerhalb eines Projektkontextes. Das bringt bereits einiges – Chats lassen sich leichter referenzieren, ein echter Projektkontext baut sich über Zeit auf. Nur bleiben diese Projekte dabei in sich geschlossen. Sobald zwei Projekte größere inhaltliche Schnittmengen haben, will man den Detail-Kontext zwar weiterhin im jeweiligen Projekt belassen – aber zusätzlich eine Ebene, auf der man von den Inhalten der anderen zumindest weiß. Genau das übernimmt bei mir das LLM-Wiki: eine projektübergreifende Kontext-Basis, in der sich Informationen schnell wiederfinden lassen oder ich als Nutzer proaktiv darauf verweisen kann ("du weißt, wie wir arbeiten").
Eine zweite Schicht für die Spielregeln
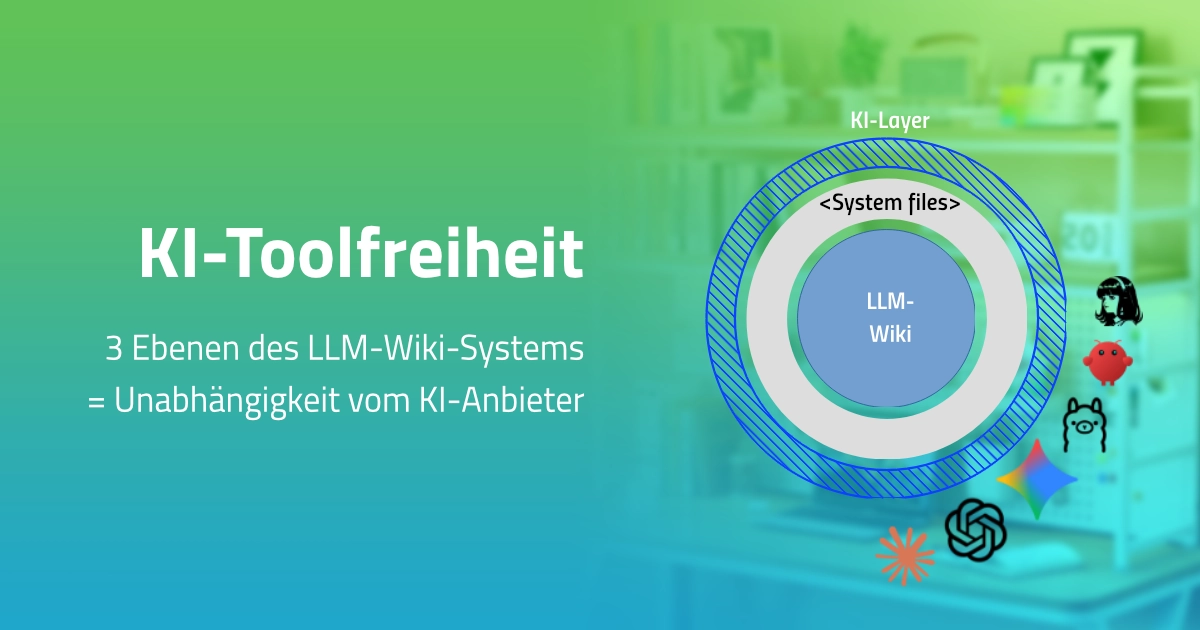
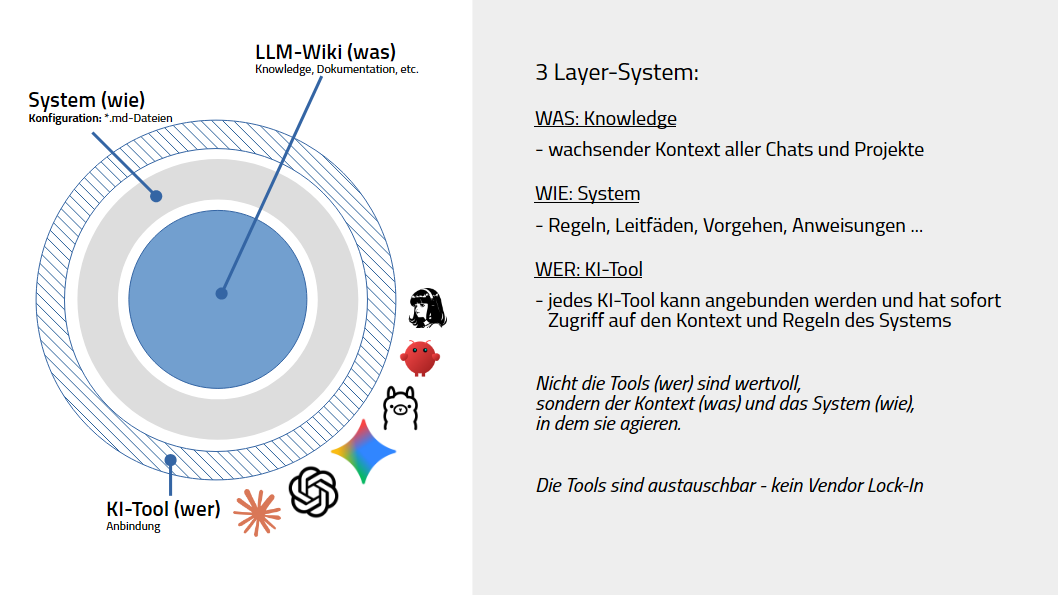
Innerhalb dieses LLM-Wikis gibt es noch eine weitere, eigene Ebene: die System-Ebene. Dort liegen Leitfäden, Rollenbeschreibungen und Skills – nicht das Wissen selbst, sondern die Regeln, nach denen mit diesem Wissen gearbeitet wird. Durch diese zweite Schicht lässt sich an den eigentlichen Kern, das LLM-Wiki, grundsätzlich jedes KI-Tool andocken und relativ schnell mit dem vorhandenen Kontext vertraut machen.
Drei Schichten: Wissen, Regeln, Werkzeug
Daraus ergibt sich ein Drei-Schichten-Modell: WAS – das Wissen, also das eigentliche LLM-Wiki, der wachsende Kontext aller Chats und Projekte. WIE – das System, also Regeln, Leitfäden und Vorgehen als eigene *.md-Konfiguration, unabhängig von den Wissensinhalten. WER – das Werkzeug, aktuell Claude, grundsätzlich aber austauschbar. Interessant dabei: Nicht nur das KI-Tool selbst ist austauschbar, auch die Software, in der die WAS-Ebene technisch geführt wird – bei mir aktuell Obsidian – ließe sich grundsätzlich ersetzen, solange das Zielformat bei einfachen Markdown-Dateien mit Frontmatter bleibt.
Der Denkfehler, den ich korrigieren musste
Meine erste Einordnung dieser Drei-Schichten-Trennung war schief gewichtet: Ich hatte den Schwerpunkt auf die Vermeidung von Vendor-Lock-In gelegt – also darauf, nicht an ein einzelnes KI-Tool gebunden zu sein. Das ist zwar ein echter Vorteil dieser Architektur, aber eben nicht ihr eigentlicher Zweck. Das vorrangige Ziel bleibt ein anderes, rein prozessuales: aus passiv gesammeltem Wissen aktiv nutzbares Wissen zu machen – genau das Second-Brain-Ziel, dem sich der nächste Beitrag dieser Serie widmet. Die Trennung von Wissen und Regeln sorgt dafür, dass diese Regeln nicht in einzelnen Chat-Konfigurationen verwässern, sondern an einem Ort dauerhaft erhalten bleiben. Dass dadurch zusätzlich jedes KI-Tool dieselben Regeln vorfindet, ohne dass sich am Wiki selbst etwas ändern müsste, ist eine wertvolle Nebenfolge dieser Architektur – kein eigenständiges Ziel daneben.
Ergebnis
Diese Klarstellung – Werkzeugunabhängigkeit als Nutzen, nicht als Zweck – ist inzwischen fest im Zielverständnis-Dokument meines Second Brain verankert und dient seither als Leitplanke für alle weiteren Architekturentscheidungen: Jede neue Regel, jeder neue Leitfaden landet in der WIE-Ebene, nicht vermischt mit dem eigentlichen Wissen.
Ausblick
Mit dieser Drei-Schichten-Architektur im Kopf – Wissen, Regeln, Werkzeug sauber getrennt – konnte ich mich der eigentlich drängenderen Frage zuwenden: Nach welcher inhaltlichen Logik soll das Wissen selbst überhaupt geordnet werden? Davon handelt der nächste Teil dieser Serie.